

Notice de lecture — 15 octobre 2026
Nature et portée : synthèse de sources et proposition d’architecture de référence. Ce document n’est ni une publication évaluée par les pairs, ni un compte rendu d’expérience LinkTec, ni une référence client.
Rectification de portée : les mentions du manuscrit « déploie », « construit », « auditable », « souverain » ou équivalentes décrivent ici des objectifs d’architecture à vérifier par projet ; elles n’attestent aucun déploiement client, équipement exploité, certification ou résultat LinkTec. Les hypothèses ne constituent pas un programme de recherche réalisé ni une promesse de publication.
Les résultats chiffrés cités restent ceux de leurs auteurs, dans leurs protocoles. Les formulations générales, recommandations et seuils ne sont pas des garanties applicables à toute charge de travail. La revue de lecture et des références principales n’est pas une réplication des expériences ni une validation scientifique exhaustive.
Déploiement chez le client ou sur un cloud choisi avec lui. Origine, taille et ouverture d’un modèle ne déterminent ni son lieu d’exécution ni ses droits commerciaux. Versions, licences, accès et dépendances doivent être vérifiés. Aucune API externe de modèle sans demande du client.
Mise à jour éditoriale du 20 octobre 2026 : la règle de recours aux API de modèles couvre tous les fournisseurs externes, quelle que soit leur origine.
Précisions : le contexte peut limiter un système, sans être son unique goulot d’étranglement. Les effets de position et de longueur dépendent du modèle et de la tâche ; aucun seuil universel de 32k tokens ou de perte de précision n’est établi ici. Les réductions relatives de 35 %, 49 % et 67 % des échecs de retrieval top-20 sont rapportées par Anthropic sur ses corpus, pas par LinkTec. Les variantes de retrieval agentique citées n’implémentent pas toutes la même boucle. Les nombres de candidats, gains GraphRAG et cibles d’évaluation ne sont pas des constantes de production.
Au-delà du RAG : l'essor de l'architecture de contexte Concevoir la couche de contexte des agents autonomes.
Le RAG (Retrieval-Augmented Generation) a rendu les grands modèles de langage utiles sur des données privées. Mais le pipeline en une passe — embed, search, stuff, generate — a été conçu pour une question humaine unique, pas pour des agents autonomes qui émettent des milliers d'appels et accumulent un état. À mesure que les agents passent en production, le verrou n'est plus le modèle ni l'index vectoriel ; c'est la couche de contexte : ce qui atteint le modèle, quand, sous quelle forme, et à quel coût. Cette note repositionne le RAG comme un composant d'une discipline plus large — l'architecture de contexte — et passe en revue les techniques qui définissent désormais l'état de l'art : retrieval hybride et contextuel, modèles à late interaction, boucles de retrieval agentique (auto-correctives), raisonnement structuré par graphe, gestion du budget de contexte, et les méthodes d'évaluation qui maintiennent l'ensemble honnête. Nous terminons par l'architecture de référence que LinkTec Labs déploie pour les organisations qui passent du POC à la production.
01 — LA BASCULE
Du prompt malin au contexte conçu
Le RAG — Retrieval-Augmented Generation — fut l'idée qui a débloqué l'adoption des modèles de langage en entreprise : plutôt que de fine-tuner un modèle sur des données privées, on récupère les passages pertinents au moment de la requête et on laisse le modèle les lire. Cela a fonctionné. Cela a aussi, discrètement, posé un plafond. Le pipeline canonique — découper le corpus, l'embedder, lancer une recherche du plus proche voisin sur la question de l'utilisateur, concaténer les meilleurs résultats, puis générer — suppose une question humaine unique et bien formée, et une seule passe. Cette supposition s'effondre dès que l'appelant est un agent.
Les agents autonomes ne posent pas une question. Ils planifient, appellent des outils, lisent les résultats, révisent, et rappellent — émettant des ordres de grandeur plus de requêtes qu'un humain, et transportant entre chaque étape un état de travail qui ne cesse de croître. La ressource rare se déplace de la qualité du modèle vers la qualité du contexte : la fenêtre limitée doit être remplie, à chaque étape, avec exactement l'information et les outils que la décision suivante exige — et rien d'autre.
Andrej Karpathy l'a résumé : le LLM est un nouveau type de système d'exploitation, et la fenêtre de contexte en est la RAM. Le travail de l'ingénieur, c'est la gestion de mémoire.
C'est pourquoi le champ est passé, en l'espace de deux ans, du prompt engineering à ce qu'on appelle désormais le context engineering — et, à l'échelle de la production, à l'architecture de contexte : la conception systématique des pipelines, index, contrôleurs et budgets qui décident de ce que voit le modèle. Anthropic a publié des recommandations explicites sur la pratique; les analystes la décrivent désormais comme la discipline qui succède au prompt engineering. La thèse de cette note est simple et, nous le croyons, lourde de conséquences : Le verrou de l'IA appliquée n'est plus le modèle. C'est l'architecture du contexte qui l'entoure.
Pour un éditeur de modèles, c'est une note de bas de page. Pour une organisation qui tente de mettre des agents en production sur ses propres données, souvent désordonnées, c'est tout l'enjeu — et il est constructible, mesurable, et appropriable. La suite de cette note en dresse le terrain.
02 — L'ILLUSION DU LONG CONTEXTE
Pourquoi « tout coller » échoue
Le premier réflexe, quand le contexte compte, est d'agrandir la fenêtre. Les modèles de pointe affichent désormais des fenêtres de centaines de milliers — voire de millions — de tokens, et une conclusion tentante s'ensuit : si tout tient, le retrieval est obsolète. Les faits disent le contraire. Les longues fenêtres sont nécessaires mais pas suffisantes, car les modèles n'exploitent pas un long contexte de façon uniforme.
Deux modes de défaillance sont aujourd'hui bien documentés. Le premier est positionnel : Liu et al. ont montré que la performance sur les tâches multi-documents suit une courbe en U — la précision est maximale lorsque l'information pertinente se trouve tout au début ou tout à la fin de l'entrée, et chute de plus de trente pour cent lorsque cette même information est enfouie au milieu. Le phénomène — « lost in the middle » — se reproduit d'une famille de modèles à l'autre. Le second est cumulatif : l'étude context rot de Chroma démontre qu'à mesure que l'entrée brute grossit, la performance se dégrade de façon non uniforme, souvent bien avant la limite annoncée, l'attention se diluant sur davantage de tokens et le modèle étant plus facilement attiré par du matériel cohérent mais hors-sujet.
30 % Chute de précision quand les faits pertinents sont au milieu plutôt qu'aux extrémités (« lost in the middle »).
~32k Seuil de tokens au-delà duquel de nombreux modèles de pointe tombent nettement sous leur précision court-contexte, en tests indépendants.
NIAH Le « needle in a haystack » ne mesure que le rappel lexical — il surestime le vrai raisonnement long-contexte.
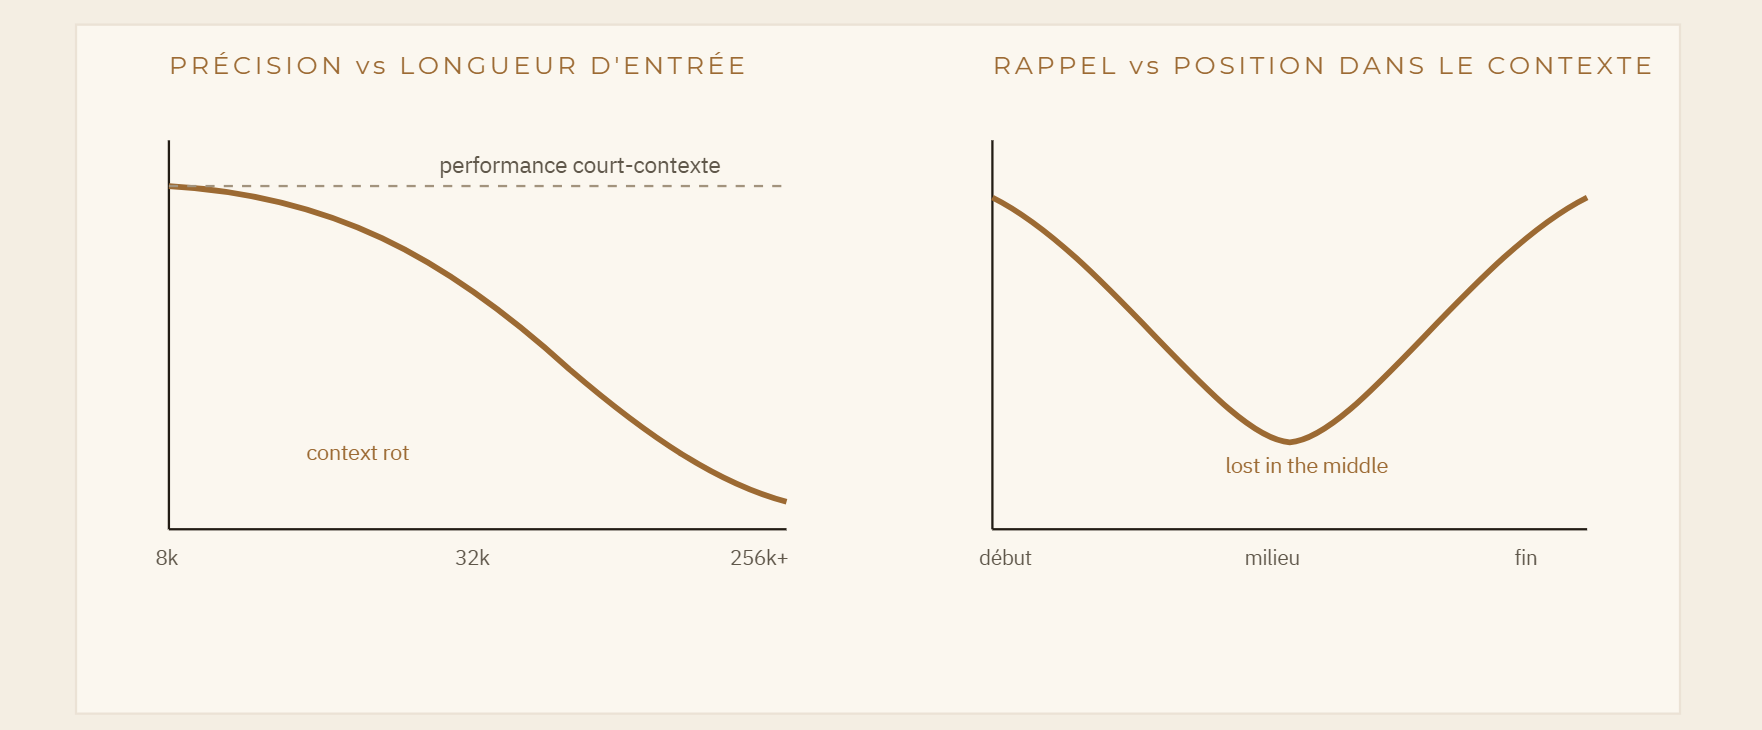
La conséquence opérationnelle est décisive. Une fenêtre plus grande ne supprime pas le besoin de choisir ce qu'on y met — elle augmente le coût d'un mauvais choix. Le retrieval n'est pas un palliatif aux petites fenêtres ; c'est le mécanisme par lequel on maintient un ratio signal/token élevé, quelle que soit la taille de la fenêtre. L'architecture de contexte commence ici.
03 — LE SUBSTRAT DE RETRIEVAL, BIEN FAIT
Hybride, contextuel, reranké, late-interaction
Si le retrieval est permanent, il doit être excellent. La base naïve — vecteurs denses sur des chunks de taille fixe — laisse énormément de précision sur la table. Quatre améliorations constituent désormais le standard de production.
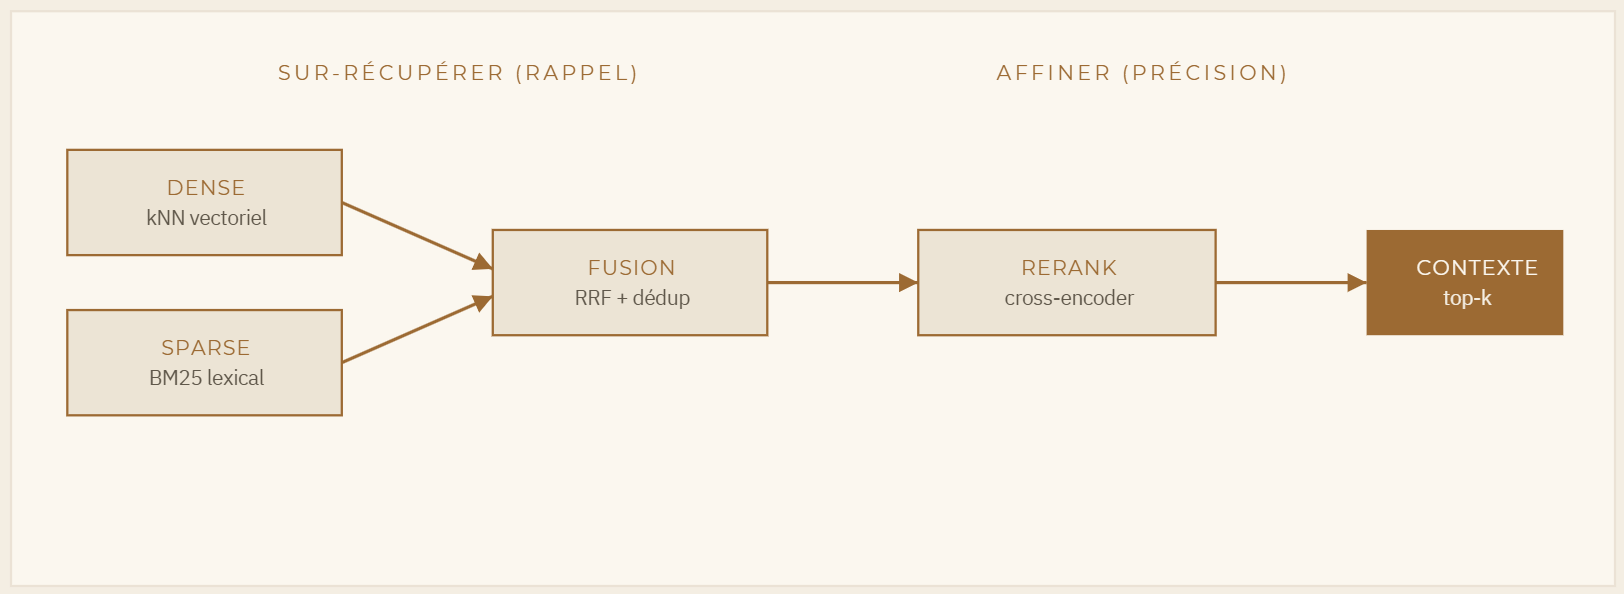
Retrieval hybride et rank fusion Les embeddings denses capturent la similarité sémantique mais ratent les termes exacts — identifiants, codes d'erreur, noms propres, tokens rares — que les méthodes lexicales (sparse) comme BM25 attrapent de façon fiable. Le réglage robuste par défaut est d'exécuter les deux et de fusionner leurs résultats par Reciprocal Rank Fusion, puis de dédupliquer. Le retrieval hybride est aujourd'hui le point de départ recommandé pour pratiquement tout système de production.
Contextual retrieval Le chunking détruit le contexte : un paragraphe qui dit « la marge est tombée à 3,2 % » perd l'entité et la période auxquelles il se réfère. Le contextual retrieval d'Anthropic préfixe à chaque chunk une courte description, générée par le modèle, qui le situe dans son document, avant l'indexation — à la fois pour l'embedding et pour l'index BM25. L'effet mesuré est important : les contextual embeddings réduisent les échecs de retrieval (top-20) de 35 % ; l'ajout de contextual BM25 atteint 49 % ; l'ajout d'un reranker atteint 67 %.
49 % D'échecs de retrieval en moins avec contextual embeddings + contextual BM25 vs. une base standard.
67 % D'échecs de retrieval en moins une fois une étape de reranking ajoutée.
50–100 Candidats à récupérer avant reranking par cross-encoder — un entonnoir de production courant.
Reranking Le retrieval de premier étage optimise le rappel ; il renvoie de nombreux candidats plausibles. Un reranker de type cross-encoder — qui lit conjointement la requête et le passage, plutôt que de comparer des vecteurs pré-calculés — les réordonne ensuite pour la précision. Le motif consiste à sur-récupérer (50–100 candidats) puis à reranker jusqu'à la poignée qui entre réellement dans le prompt, échangeant un faible surcoût de latence contre un gain de précision substantiel. L'arbitrage entre le nombre de candidats rerankés et la latence ajoutée est le bouton de réglage central.
La late interaction conserve des représentations par token plutôt qu’un seul vecteur agrégé. ColBERT combine ces représentations par une opération MaxSim. ColPali applique une approche multi-vecteurs aux pages rendues, afin d’exploiter aussi leur structure visuelle. Le bénéfice et le coût doivent être évalués sur le corpus visé.
04 — DES PIPELINES AU RETRIEVAL AGENTIQUE
Le retrieval comme boucle de contrôle
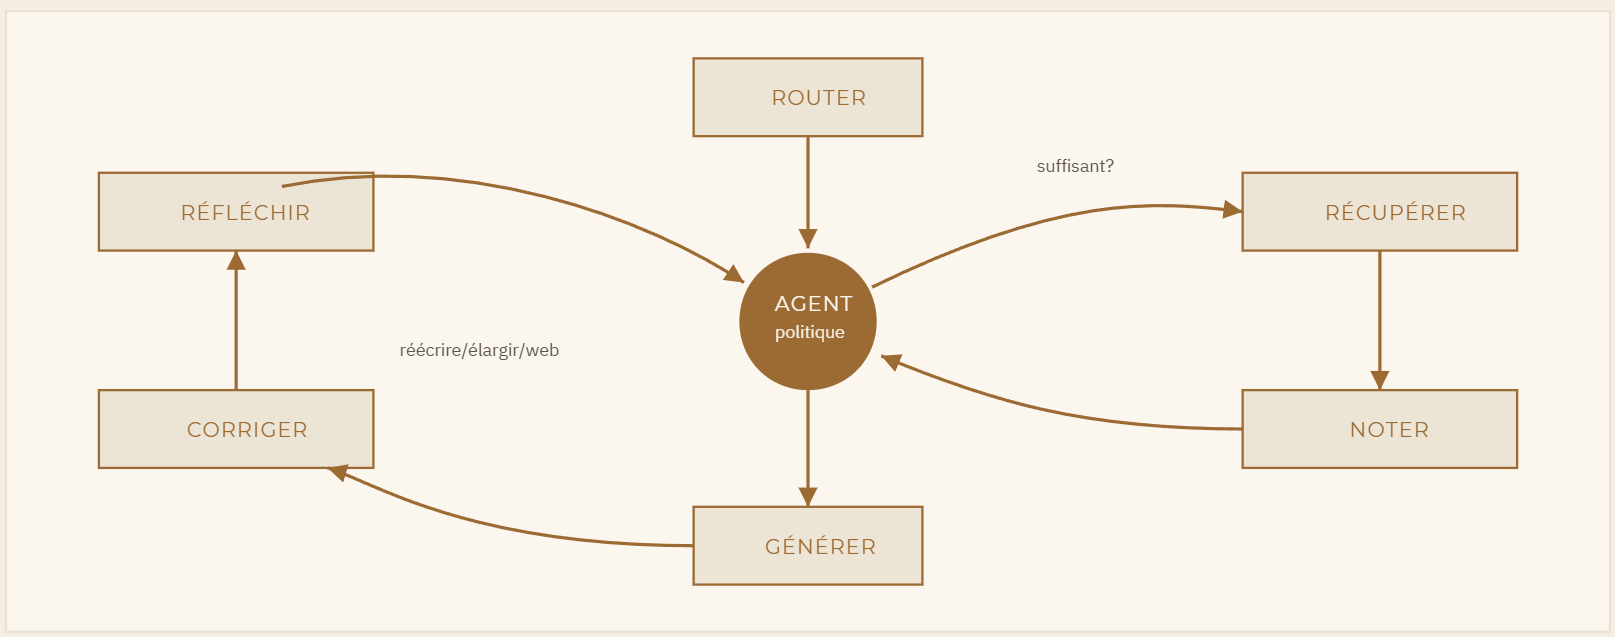
Même un excellent entonnoir ne s'exécute qu'une fois. La bascule plus profonde consiste à laisser l'agent contrôler le retrieval : décider s'il faut récupérer, juger si ce qui revient est suffisant, et agir pour corriger sinon. Quatre motifs nommés, issus de la littérature, composent aujourd'hui la plupart des systèmes de production.
Le retrieval peut devenir un outil contrôlé plutôt qu’un préambule fixe. Self-RAG apprend notamment à récupérer à la demande et à critiquer les passages et générations au moyen de jetons de réflexion.
Corrective RAG (CRAG) ajoute un évaluateur léger qui note la pertinence des documents récupérés et, sur un score faible, déclenche une action corrective — réécriture de requête ou repli web — plutôt que de répondre sur un contexte médiocre.
FLARE récupère de façon active, en générant vers l'avant et en s'arrêtant pour chercher des preuves dès que sa confiance sur le prochain token baisse — un retrieval piloté par l'incertitude du modèle.
Adaptive-RAG route selon la difficulté : un petit classifieur envoie les questions faciles directement à la génération et réserve la boucle multi-étapes coûteuse aux questions réellement difficiles — pilotant le coût, pas seulement la précision.
Certaines questions nécessitent de relier des informations réparties dans le corpus. GraphRAG construit un graphe d’entités et des résumés de communautés pour des questions de synthèse globale. Les gains rapportés par ses auteurs dépendent de leur protocole ; ils ne constituent pas un gain LinkTec ni une valeur attendue pour toute tâche. La construction et la maintenance du graphe ont aussi un coût.
05 — LE BUDGET DE CONTEXTE
Gérer la fenêtre comme une hiérarchie mémoire
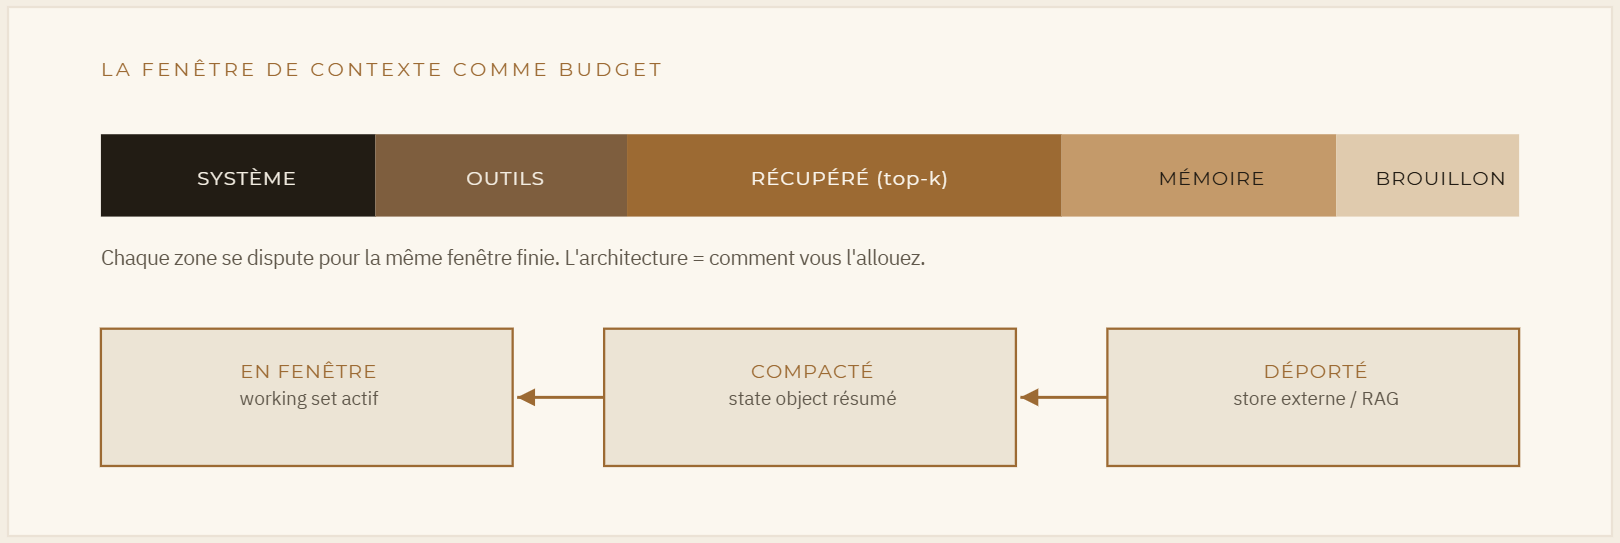
Le retrieval décide de ce qui pourrait entrer dans la fenêtre. Le budget de contexte décide de ce qui y entre réellement, tour après tour, à mesure qu'un agent s'exécute sur des dizaines, voire des centaines d'étapes. C'est là que la plupart des agents de production échouent en silence : non pas sur une réponse isolée, mais à la quarantième, quand la fenêtre s'est remplie de transcripts d'outils et que le modèle perd le fil. Traiter la fenêtre comme une hiérarchie mémoire gérée — et non comme un seau — fait toute la différence.
Trois techniques portent l'essentiel de la charge. Le context editing élague le contenu à faible signal (sorties d'outils périmées, brouillons remplacés) par règle, avant qu'il ne s'accumule ; dans l'évaluation à cent tours d'Anthropic, le context editing a réduit la consommation de tokens de 84 % et permis à des workflows d'aboutir là où ils auraient autrement épuisé la fenêtre. La compaction résume périodiquement l'historique en un state object compact, préservant les décisions et écartant le transcript. L'isolation par sous-agents donne à chaque sous-tâche sa propre fenêtre propre et ne renvoie qu'un résumé condensé — typiquement un à deux mille tokens — à l'orchestrateur, de sorte que le contexte de l'agent principal n'absorbe jamais l'état de travail complet de ses délégués.
PRINCIPE DE CONCEPTION Le budget de tokens se gère avant que le contenu n'entre dans la fenêtre, pas après. Chaque token dépensé en matériel à faible signal est payé deux fois — une fois en coût, et une autre en précision perdue au context rot.
RAG, contexte caché et lecture directe répondent à des contraintes différentes. Un petit corpus stable et uniformément autorisé peut se prêter au contexte long ou au cache. Un corpus volumineux, changeant ou multi-utilisateur appelle une recherche contrôlée en accès. La voie graphe reste optionnelle, selon les questions et les tests.
06 — MESURER CE QUI COMPTE
L'évaluation comme système de contrôle
L’évaluation distingue la qualité de la recherche et celle de la génération. RAGAS propose plusieurs mesures de pertinence et de fidélité au contexte ; Precision@k et Recall@k sont utiles avec un jeu de requêtes et de documents annotés. Les cibles dépendent du domaine et du risque, sans seuil universel.
Context precision & recall — les chunks récupérés sont-ils pertinents, et contiennent-ils effectivement la réponse ? Ces métriques isolent le retriever du générateur.
Faithfulness — décomposée comme la part des affirmations atomiques de la réponse qui sont directement étayées par le contexte récupéré. La métrique de première ligne contre l'hallucination.
Answer relevance — la réponse traite-t-elle réellement la question posée ?
La fidélité au contexte est un indicateur à calibrer avec une revue humaine et des cas d’échec. Un score isolé ne démontre ni l’absence d’hallucination ni la conformité d’un système.
07 — UNE ARCHITECTURE DE RÉFÉRENCE
La couche de contexte comme architecture de référence
Les techniques décrites peuvent se combiner dans l’architecture de référence ci-dessous. Il s’agit d’une proposition logique à adapter, sans affirmation de déploiement client ou de mesure LinkTec.
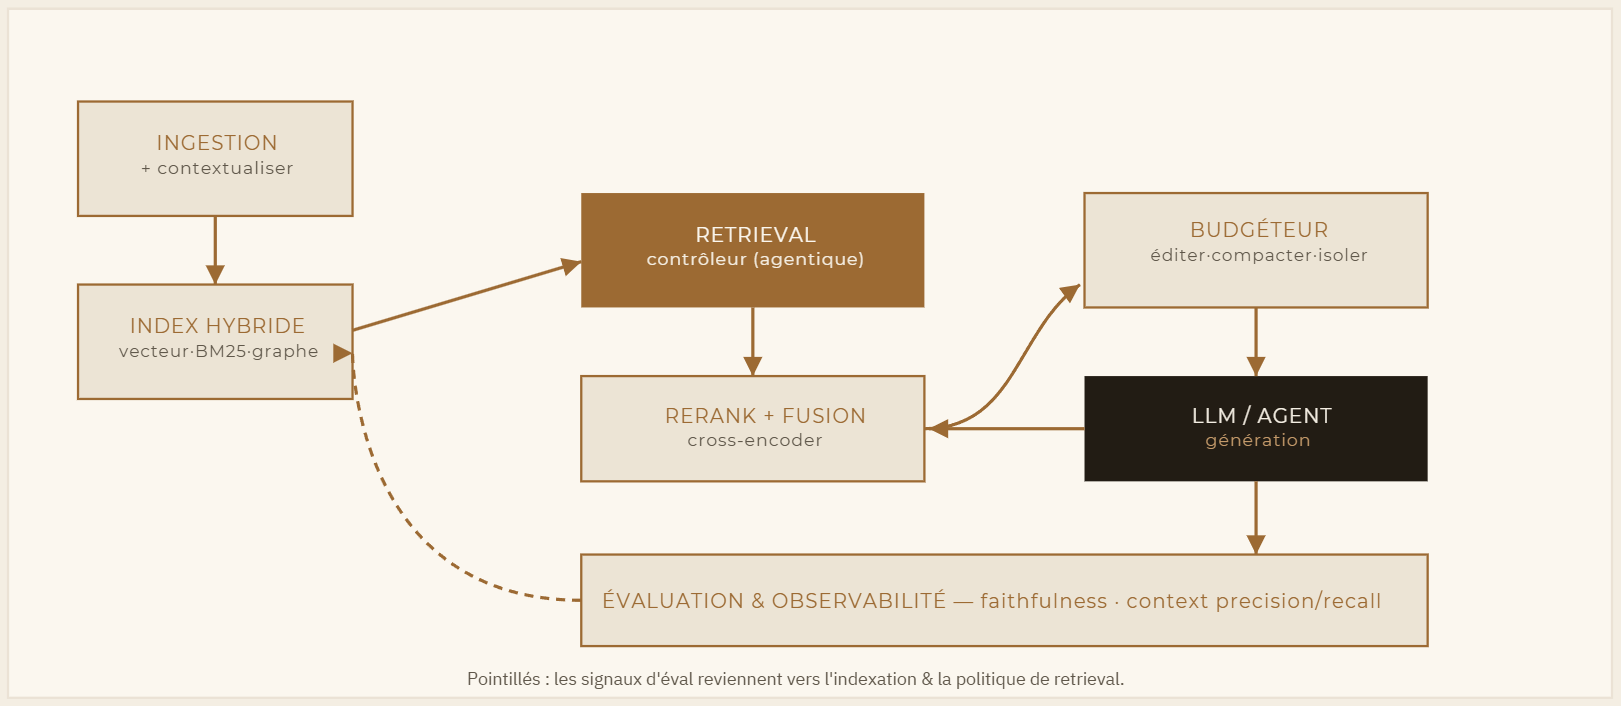
Quatre principes la gouvernent. La qualité du retrieval est le produit — l'indexation contextuelle et le reranking ne sont pas un vernis optionnel mais le plancher de précision. Le contrôleur est explicite — le retrieval est un outil gouverné, avec routage et notation, jamais un préambule aveugle. Le budget est conçu — la fenêtre est allouée, éditée et compactée selon une politique, et non laissée se remplir.
Une mise en œuvre doit définir ce qui est mesuré, la portée des traces et leur durée de conservation. La présence d’un schéma ne prouve pas que ces contrôles sont installés ou validés.
08 — PLAYBOOK DU PRATICIEN
Quoi faire dès lundi
Le modèle est une commodité. Le contexte qui l'entoure est l'architecture — et l'architecture est là où vit l'avantage.
Le playbook propose de sélectionner le contexte, d’établir une référence simple, puis de tester chaque évolution de retrieval et de budget sur le corpus concerné.
Faire de l'hybride le défaut. Dense + BM25 + RRF avant toute exotisme ; c'est le coup d'ouverture au meilleur rendement.
Contextualiser les chunks avant l'indexation. Une ligne de description situant chaque chunk est parmi les gains de précision les moins chers disponibles.
Sur-récupérer, puis reranker. 50–100 candidats dans un cross-encoder, jusqu'à un top-k précis.→ Donner à l'agent une politique de retrieval. Router par difficulté, noter la suffisance, corriger sur échec — ne répondez pas sur un mauvais contexte.
Budgéter la fenêtre comme de la mémoire. Éditer, compacter, isoler les sous-agents ; traiter les tokens comme une ressource gérée.
Apparier le mécanisme au corpus. RAG, contexte caché, contexte long et graphe sont des choix d’architecture à tester selon le besoin.
Instrumenter avant d'optimiser. Faithfulness et context precision/recall, suivies dans le temps, ou vous devinez.